
Jev
Jev 的作者是 Diogo Almeida,他参与过 InstructGPT 与 ChatGPT 的早期开发,是 RLHF 的共同发明人,此前在 OpenAI 任研究员,后来在旧金山创办了 TypeSafe AI。公司刚完成由 DCVC 领投的 4000 万美元种子轮,并于 2026 年 9 月 15 日发布了 Jev。
Jev 上线 Vercel AI Gateway 的 24 小时内,近 13% 的付费团队用过它,是该网关历史上新模型采用最快的一次,同期采用率达到 GPT-5.6 系列的两倍以上、Fable 5.1 的六倍以上。Jev 在开发者社区迅速出圈,现在已经对所有人开放:注册用户会获得 5 美元初始额度,由于其极低的定价策略,这笔额度相当于直接送出约 1.2 亿个 Token。
概述
需要说明的是,Jev 并不是又一个生成式模型。它不会根据用户的问题来生成答案,只做一件事情——选择。
在大多数模型都在比拼生成长度、对话能力和长文本推理的时候,Jev 走了一条完全相反的路。它不写文章,也不做开放式问答,只接收一段上下文与预设的几个选项,然后直接输出各个选项的概率。
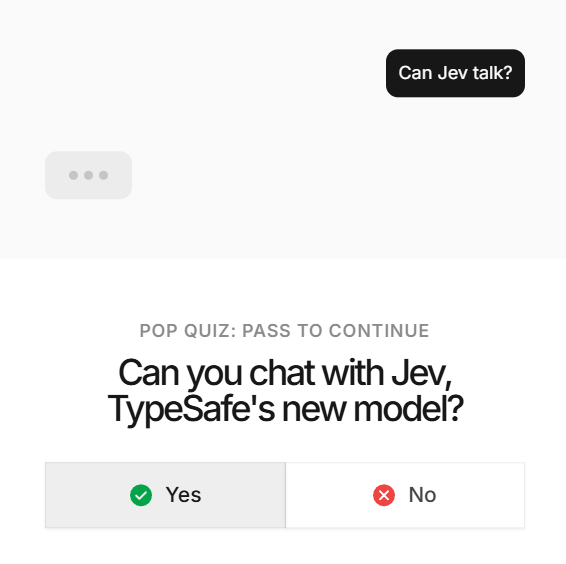
第一次进入 Jev 官网注册时,会弹出一道小测验,让我们判断 Jev 是否可以问答。
本文的内容主要分为三部分:
- Jev 的模型形态与三种题型:它为什么不做问答题,只做选择题;
- 官方 API 演示:请求长什么样,返回什么;
- 开源复刻模型:Laya、Kev、SemIf-OpenJev 三条路线,分别把「决策能力」放在了模型的哪个位置。
下面逐一展开。
Jev 模型
从模型形态上看,Jev 不属于逐词预测的自回归生成模型,而是退回到了专门做分类与判断的判别式模型,可以简单理解为 BERT,但具体的模型架构并没有开源。
开发者把待分析的文本作为输入,同时递给它几个固定选项。Jev 在运行后不吐出任何自然语言,而是像扫描一样,直接给每一个选项打出确切的概率。
大家或许会有疑惑:我直接调用大模型就可以了,为什么要用 Jev?
这是因为,调用常见的大语言模型时,哪怕你在提示词里写明了「请只回答是或否,不要输出任何多余内容」,模型的底层逻辑依然是在写作文。它必须走自回归流程,一个 Token 一个 Token 地往外吐字。有时候它老老实实输出「是」,有时候却会多吐出标点符号、解释前缀或者换行符,输出的稳定性无法保证。开发者为了在代码里使用这个结果,还得专门写正则表达式去清洗返回的文本;一旦大模型没按预期格式出牌,后续业务逻辑就会直接报错。
让一个擅长写长文的生成模型来做这种是非判断,不仅慢、计费贵,而且输出格式随时可能失控。
因此,Jev 从根本上不做问答题,只做选择题。
这种选择题被抽象成了三种最基础的题型:
- Choice(单选题),用于多分类标签。模型直接返回各个分类的概率。
- Score(评分题),用于有序刻度打分。比如在 1 到 5 分之间评估内容的匹配度或风险等级,返回各档位的分布与加权分。
- Noul(判断题),用于纯粹的二元是非判断。直接评估某个命题是真是假。
三种题型的返回字段并不相同。
| Type | What it answers | Returns |
|---|---|---|
| Choice | Which of these options? | choice, probabilities, confidence |
| Score | Which level? | score, legend, probabilities, confidence |
| Noul | Is this true? | noul (0 to 1) |
Noul 是唯一不带 confidence 字段的题型。官方的解释是它的分布只有两个结果,一个数就能完整描述。
Choice 和 Score 都把概率摊在多个选项或等级上,需要 confidence 概括摊开的程度。
score 不是等级编号,是等级编号按概率加权后的位置。
legend 的作用是把数字编号映射回你写的等级描述,避免回头查代码。
usage 里有两个 token 计数。output_tokens 并不是 0,官方示例里它是 18 到 212 之间的正数,统计的是结构化答案占用的 token,不是模型生成的自然语言。
开发者拿到的是带类型的值和概率分布,代码可以直接分支、排序和路由。
三种题型可以混在同一次请求里。官方文档的说法是,每个问题会对同一份 state 并行、隔离地求值,增加问题几乎不改变响应时间,只多花少量 question token。
演示
Jev 官方文档中给出了一个购物场景的请求示例:
{
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
把请求发送给模型,返回的 response 如下:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  },
  "usage": {
    "input_tokens": 328,
    "output_tokens": 34
  }
}
开源复刻模型
Jev 的架构未被公开发表。TypeSafe 仅表示,该模型通过一次查询生成所有输出,而非一次只输出一个 Token,返回带有校准概率的答案,并用 RLCD 在合成数据上训练。截至目前,参数数量、基础架构、权重和训练方法均未公开。也正因如此,开源社区在复刻 Jev 能力的过程中产生了大概三种架构。
Laya
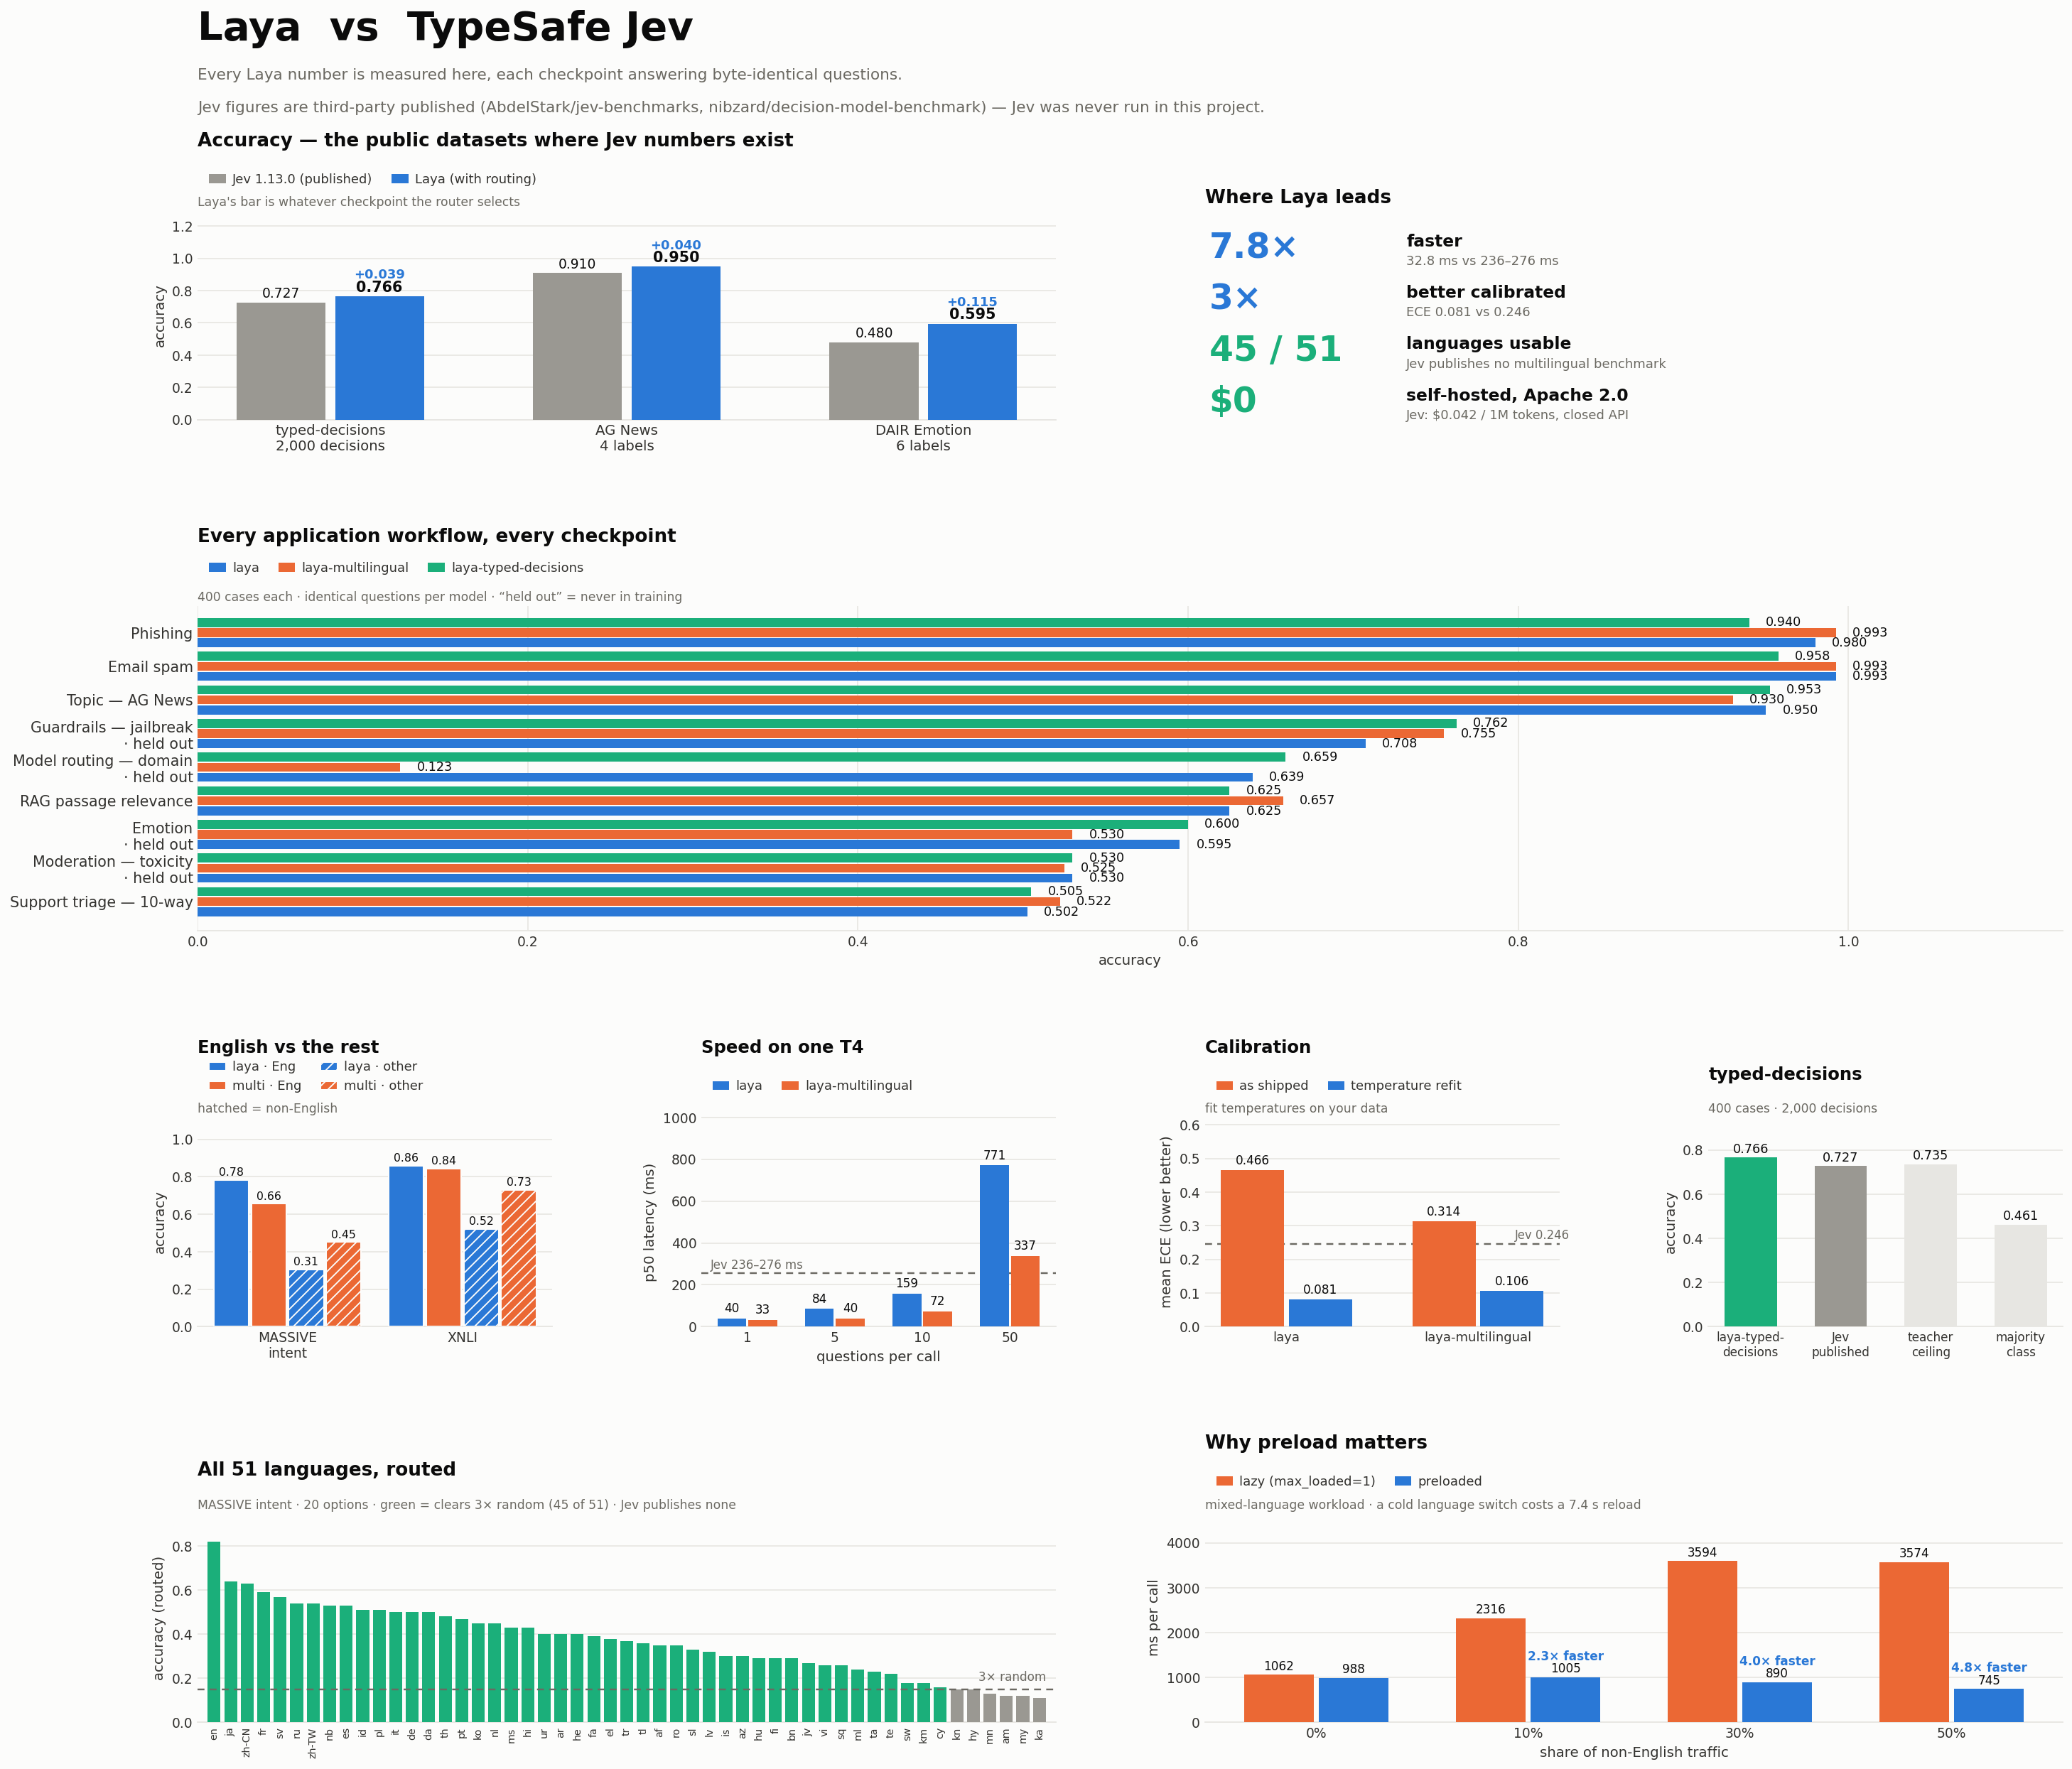
第一个流派走双向编码器路线,主打轻量、极速与多语言,代表作是开源项目 Laya。Laya 采用 ModernBERT 与多语言 mmBERT 构建,单张消费级显卡上的延迟仅 32.8 毫秒,甚至比 Jev 的远程接口快数倍。更关键的是,它内置了多字符集检测分流器,支持 100 多个语种,成为目前中文与多语言自建环境的首选。该项目截至 2026 年 9 月 24 日已积累 20.7k 颗 Star。
Laya 的具体做法如下:
例如,在一个智能体的工具选择场景中,输入状态为“当前XX地区的气象怎么查看?”,候选选项为“查询数据库”“查询天气”“查询 GIS”“发送短信”。模型可以将这些信息组织成类似下面的输入结构:
[CLS]
状态:当前XX地区的气象怎么查看?

选项1:[MASK] 查询数据库
选项2:[MASK] 查询天气
选项3:[MASK] 查询 GIS
选项4:[MASK] 发送短信
[SEP]
其中,每个 [MASK] 对应一个候选选项。整个序列一次性输入 ModernBERT,经过双向 Transformer 编码后,模型分别取出 4 个 [MASK] 位置的隐藏状态,并由决策头将它们映射为对应的候选项得分。例如:
[MASK]1 → 0.72   查询数据库
[MASK]2 → 0.08   查询天气
[MASK]3 → 0.16   查询 GIS
[MASK]4 → 0.04   发送短信
随后在这些候选项之间进行 Softmax,得到最终的决策概率,并选择概率最高的“查询数据库”。因此,Laya 并不是把每个候选项单独编码后再计算余弦相似度,而是让状态、问题和所有候选项在同一个双向 Transformer 中共同建模,再利用各自的 [MASK] 表示完成候选项打分。
Kev
第二个流派走因果解码器路线,主打大模型底座与超长上下文,代表作是近期在 Hugging Face 发布的 Kev 模型。Kev 基于 Qwen3.5 Base 构建,目前提供 0.8B、4B 和 9B 三种规模,并采用与 Jev 类似的「决策而非生成」思路:模型并不通过自回归方式逐个生成答案 Token,而是将待判断的状态、问题以及候选选项一次性输入模型,直接计算各候选项的决策概率。
Kev 的输入由 State、Question 和 Options 三部分组成。
例如在智能体工具选择场景中:
- State 可以是“当前XX地区的气象怎么查看?”
- Question 则是“应该调用哪个工具?”
- 候选项包括“查询数据库”“查询天气”“查询 GIS”和“发送短信”。
在 API 层面,Kev 并不要求用户按照固定的分类标签调用模型,而是可以在请求中动态提供候选项,因此模型面对的并不是一个固定的 N 分类问题,而是“给定当前状态和问题,在当前提供的候选项中进行选择”。官方接口的 Choice 类型最多可以提供 255 个候选项,同时还支持 Yes/No 和 Score 等其他决策形式。
在模型内部,Kev 会把这些内容组织成特殊的文本结构,例如:
<state> 当前XX地区的气象怎么查看?

<q> 应该调用哪个工具?
<opt> 查询数据库 </opt>
<opt> 查询天气 </opt>
<opt> 查询 GIS </opt>
<opt> 发送短信 </opt>
<decide>
在 Qwen3.5 的基础上,Kev 并没有重新设计 Transformer,而是保留 Qwen3.5 作为语言理解的 Backbone,并额外加入 LoRA Adapter 和 Pointer Head。
- LoRA 用于对 Qwen3.5 的内部表示进行轻量化微调;
- Pointer Head 则负责将模型的 Hidden State 转换成候选项之间的决策分数。
Pointer Head 是 Kev 区别于普通 Qwen3.5 的关键。
Qwen3.5 在得到 Hidden State 后,会通过 LM Head 将其映射到整个词表空间,然后预测下一个 Token;
Kev 则不再需要预测“查询”“天气”等自然语言 Token,而是直接利用候选项所在位置的 Hidden State 进行决策。
具体而言,模型会分别取出每个候选项结束位置 </opt> 的 Hidden State,同时取出问题末尾 <decide> 位置的 Hidden State。由于 <decide> 位于所有候选项之后,它能够结合完整的问题和候选项信息形成当前决策的上下文表示。随后 Pointer Head 将 <decide> 表示与每一个 </opt> 表示进行匹配并计算分数,最后在所有候选项之间进行 Softmax,得到概率分布。
例如,经过 Qwen3.5 编码后,Pointer Head 可能得到:
查询数据库 → 1.86
查询天气   → 3.42
查询 GIS   → 0.71
发送短信   → -0.25
经过 Softmax 后得到:
查询数据库 → 0.16
查询天气   → 0.72
查询 GIS   → 0.08
发送短信   → 0.04
因此模型最终直接选择“查询天气”,而不是生成“应该调用查询天气工具”这样的文本。
为了让模型具备这种决策能力,Kev 还需要进行专门训练。训练数据的形式与实际推理基本一致,即给定一个 State、一个 Question 以及若干候选项,同时标注其中的正确答案。
SemIf-OpenJev
第三个流派主打轻量包装与边缘交互。比如开源项目 SemIf-OpenJev,直接拿开源大模型的原生 logits 来做「语义 if 判断」,重点验证:能不能不生成文本,直接从模型的输出概率中得到决策结果。
与 Kev 不同,SemIf 并没有在 Qwen3.5 上增加 LoRA 和 Pointer Head,而是直接利用基础语言模型原有的 LM Head 完成候选项判断。
其核心思路是:既然因果语言模型本身就能够计算“下一个 Token 是什么”的概率,那么对于一个已经确定的候选集合,也可以直接读取这些候选答案 Token 在答案位置上的 logits,而不必真正执行自回归生成。SemIf 将这种方式称为直接读取 typed option probabilities,即候选项的概率由模型原生输出直接计算得到。
例如,对于一个客服路由任务,可以将输入组织为类似下面的形式:
State:
鞋子晚到了两周,而且尺码错误,同时信用卡被扣了两次。

Question:
哪个团队应该处理这个问题?

Options:
A:returns——退换货、退款、商品错误等
B:shipping——配送状态、延迟、丢件等
C:billing——扣款、发票、支付问题等

Answer:
这里的 A、B、C 并不是模型需要生成的一段自然语言,而是三个候选答案的标识符。整个文本经过 Tokenizer 后输入 Qwen3.5,模型正常执行一次 Forward。
而在 Answer 后对应的预测位置,可以得到整个词表中每个 Token 作为“下一个 Token”时的 logit。
SemIf 并不要求模型生成完整答案,而是从这个位置的输出中,只取出候选答案 A、B、C 所对应 Token 的 logits。例如:
A → 2.31
B → 0.87
C → 3.15
随后仅在当前提供的候选项之间进行 Softmax:
A → 0.287
B → 0.068
C → 0.645
最终选择概率最高的 C,再根据候选项映射得到 billing。
整个过程中模型没有生成“应该由 billing 团队处理”这样的自然语言,也没有进行 JSON 生成和解析,而是直接从一次模型前向计算的结果中得到决策。SemIf 官方实现明确采用这种「one forward pass + native option logits」的方式,并强调不会采样答案 Token。
SemIf 并没有改变语言模型的基本结构,而是改变了模型输出的使用方式。普通 LLM 通常需要继续生成 Token,直到形成完整的答案;SemIf 则在模型刚刚计算出“下一个 Token”的概率后立即停止,只读取预先声明的候选答案对应的概率。
这种设计还有一个重要特点:候选项可以在运行时动态提供,而不是要求模型在训练阶段固定一个分类标签集合。
模型始终使用相同的语言模型,只需要根据当前请求提供的候选项计算对应 Token 的 logits。因此,它并不是传统意义上的固定 N 分类模型,而更接近一个运行时动态定义候选集合的语义决策器。SemIf 的输入接口也采用 state、question 和动态 options 三部分,其中候选项由请求方在运行时提供。
不过,这种方法也存在一个明显限制:直接读取的是语言模型词表中的 Token,因此候选答案需要能够映射到模型可以直接读取的答案 Token。因此 SemIf 使用类型明确的选项标识,而不是直接将任意长度的自然语言选项作为一个分类类别。候选项的语义仍然由前面的描述提供,模型真正进行概率比较的是声明的答案 Token。
SemIf 的另一个重要设计是对 State 复用。在智能体场景中,一个较长的 State 往往需要同时回答多个不同的问题。例如同一份防汛状态可能需要连续判断“是否需要预警”“是否需要通知乡镇”“是否需要发送短信”“是否需要升级响应”等。如果每个问题都重新处理完整 State,就会重复计算大量相同的上下文。SemIf 因此提供 Shared 模式,可以先对相同 State 进行 Prefill,再将其复用于多个不同 Question 的决策,从而减少重复计算。官方测试在 37 个 State、每个 State 对应 21 个判断的工作负载上,对直接计算、前缀复用和并行后缀计算进行了比较。
总结
如果将三种开源实现放在一起,可以看到它们实际上代表了三种不同的思路:
- Laya 通过双向 Encoder 的
[MASK]表示和决策头完成候选项打分; - Kev 保留 Qwen3.5 的生成式 Backbone,通过 LoRA 和 Pointer Head 将 Hidden State 转换为动态候选项分数;
- SemIf 则进一步简化结构,完全不增加新的决策头,直接利用基础语言模型已有的 LM Head 读取候选答案 Token 的 logits。
三者虽然都试图实现“给定 State、Question 和 Options,直接返回决策概率”的能力,但对“决策能力究竟应该放在模型的哪个位置”给出了不同答案。
| 路线 | 代表项目 | 决策能力放在哪里 | 主打特点 |
|---|---|---|---|
| 双向编码器 | Laya | 选项位表示 + 决策头 | 轻量极速、多语言 |
| 因果解码器 + 微调 | Kev | LoRA + Pointer Head | 大模型底座、超长上下文 |
| 原生 logits 读取 | SemIf-OpenJev | 基础模型自带的 LM Head | 零结构改造、候选可动态定义 |
其实,Jev 并不是什么全新的概念。回想起 NLP 还处在 BERT 时代的时候,当时的主流任务就是这样的各种分类。不同的是,现在它从单一分类演变成了辅助智能体决策的形式,其中涉及的各种技术也在不断创新。
你说变了,也没变,思路和之前差不多;你说没变,其实也变了。
未来的智能体架构里,生成式大模型负责写长文、做复杂的开放式推理,轻量判别模型站在最前面管流量分流和逻辑分支,各干各最擅长的事。
参考文章
Introducing System One Models & Jev - TypeSafe AI Blog
Jev architecture: parameters, encoder or decoder, and no paper yet